
19 KiB




Cloud | Documentation | Roadmap | Discord
📕 Table des matières
💡 Qu'est-ce que RAGFlow?
RAGFlow est un moteur de RAG (Retrieval-Augmented Generation) open-source de premier plan qui fusionne les technologies RAG de pointe avec des capacités Agent pour créer une couche de contexte supérieure pour les LLM. Il offre un flux de travail RAG rationalisé, adaptable aux entreprises de toute taille. Alimenté par un moteur de contexte convergent et des modèles d'agents préconstruits, RAGFlow permet aux développeurs de transformer des données complexes en systèmes d'IA haute-fidélité, prêts pour la production, avec une efficacité et une précision exceptionnelles.
🎮 Démarrage
Essayez notre service cloud sur https://cloud.ragflow.io.


🔥 Dernières mises à jour
-
2026-09-29 Publication de RAGFlow 1.0.0-rc1.
-
2026-09-10 Ajout de l’ingestion de contenus Web à partir de sitemaps.
-
2026-08-19 Lancement de Knowledge Compilation pour générer des wikis, graphes, arbres, PageIndex, cartes mentales, chronologies et compétences au niveau des documents et des bases de connaissances.
-
2026-08-19 Lancement d’Agentic RAG avec quatre modes de réflexion : Low, Medium, High et Ultra.
-
2026-07-02 Ajout de l’ingestion de données depuis Google BigQuery et de la synchronisation incrémentielle.
-
2026-06-29 Ajout de canaux de conversation WhatsApp, DingTalk et WeCom.
-
2026-05-26 Ajout du composant Browser, qui permet aux Agents de parcourir et d’utiliser des pages Web.
-
2026-04-21 Ajout de sept modèles prédéfinis de pipelines d’ingestion de données.
-
2026-04-21 Ajout de la publication d’applications Agent, de l’exécution de code en sandbox et de la génération de graphiques.
-
2026-04-21 Ajout du stockage et de la récupération de mémoire au niveau utilisateur.
Consultez les notes de version complètes pour découvrir les autres nouveautés.
🎉 Restez informé
⭐️ Mettez une étoile à notre dépôt pour rester informé des nouvelles fonctionnalités et améliorations passionnantes ! Recevez des notifications instantanées pour les nouvelles versions ! 🌟
🌟 Fonctionnalités clés
🍭 "Quality in, quality out"
- Extraction de connaissances basée sur la compréhension approfondie des documents à partir de données non structurées aux formats complexes.
- Trouve "l'aiguille dans la meule de données" de tokens littéralement illimités.
🍱 Découpage(Chunking) basé sur des templates
- Intelligent et explicable.
- De nombreuses options de templates disponibles.
🧩 Compilation des connaissances (Knowledge Compilation)
- Transformez le contenu des documents et des jeux de données en connaissances structurées, notamment Wiki, Graph, Tree, PageIndex, Mind Map, Timeline et Skills.
- Configurez les modèles et règles de traitement, puis consultez, mettez à jour ou régénérez les résultats.
🧠 Recherche agentique (Agentic Retrieval)
- Le modèle analyse les questions complexes et peut les décomposer, rechercher des connaissances et vérifier les preuves en plusieurs étapes.
- Les modes Low, Medium, High et Ultra permettent de régler la profondeur de recherche et de raisonnement selon la complexité de la question.
🌱 Citations fondées avec réduction des hallucinations
- Visualisation du découpage de texte pour permettre une intervention humaine.
- Aperçu rapide des références clés et citations traçables pour soutenir des réponses fondées.
🍔 Compatibilité avec des sources de données hétérogènes
- Prend en charge Word, présentations, Excel, txt, images, copies numérisées, données structurées, pages web, et plus encore.
🛀 Flux de travail RAG automatisé et sans effort
- Orchestration RAG rationalisée adaptée aux particuliers comme aux grandes entreprises.
- LLM et modèles d'embedding configurables.
- Rappel multiple associé à un ré-classement fusionné.
- APIs intuitives pour une intégration transparente avec les entreprises.
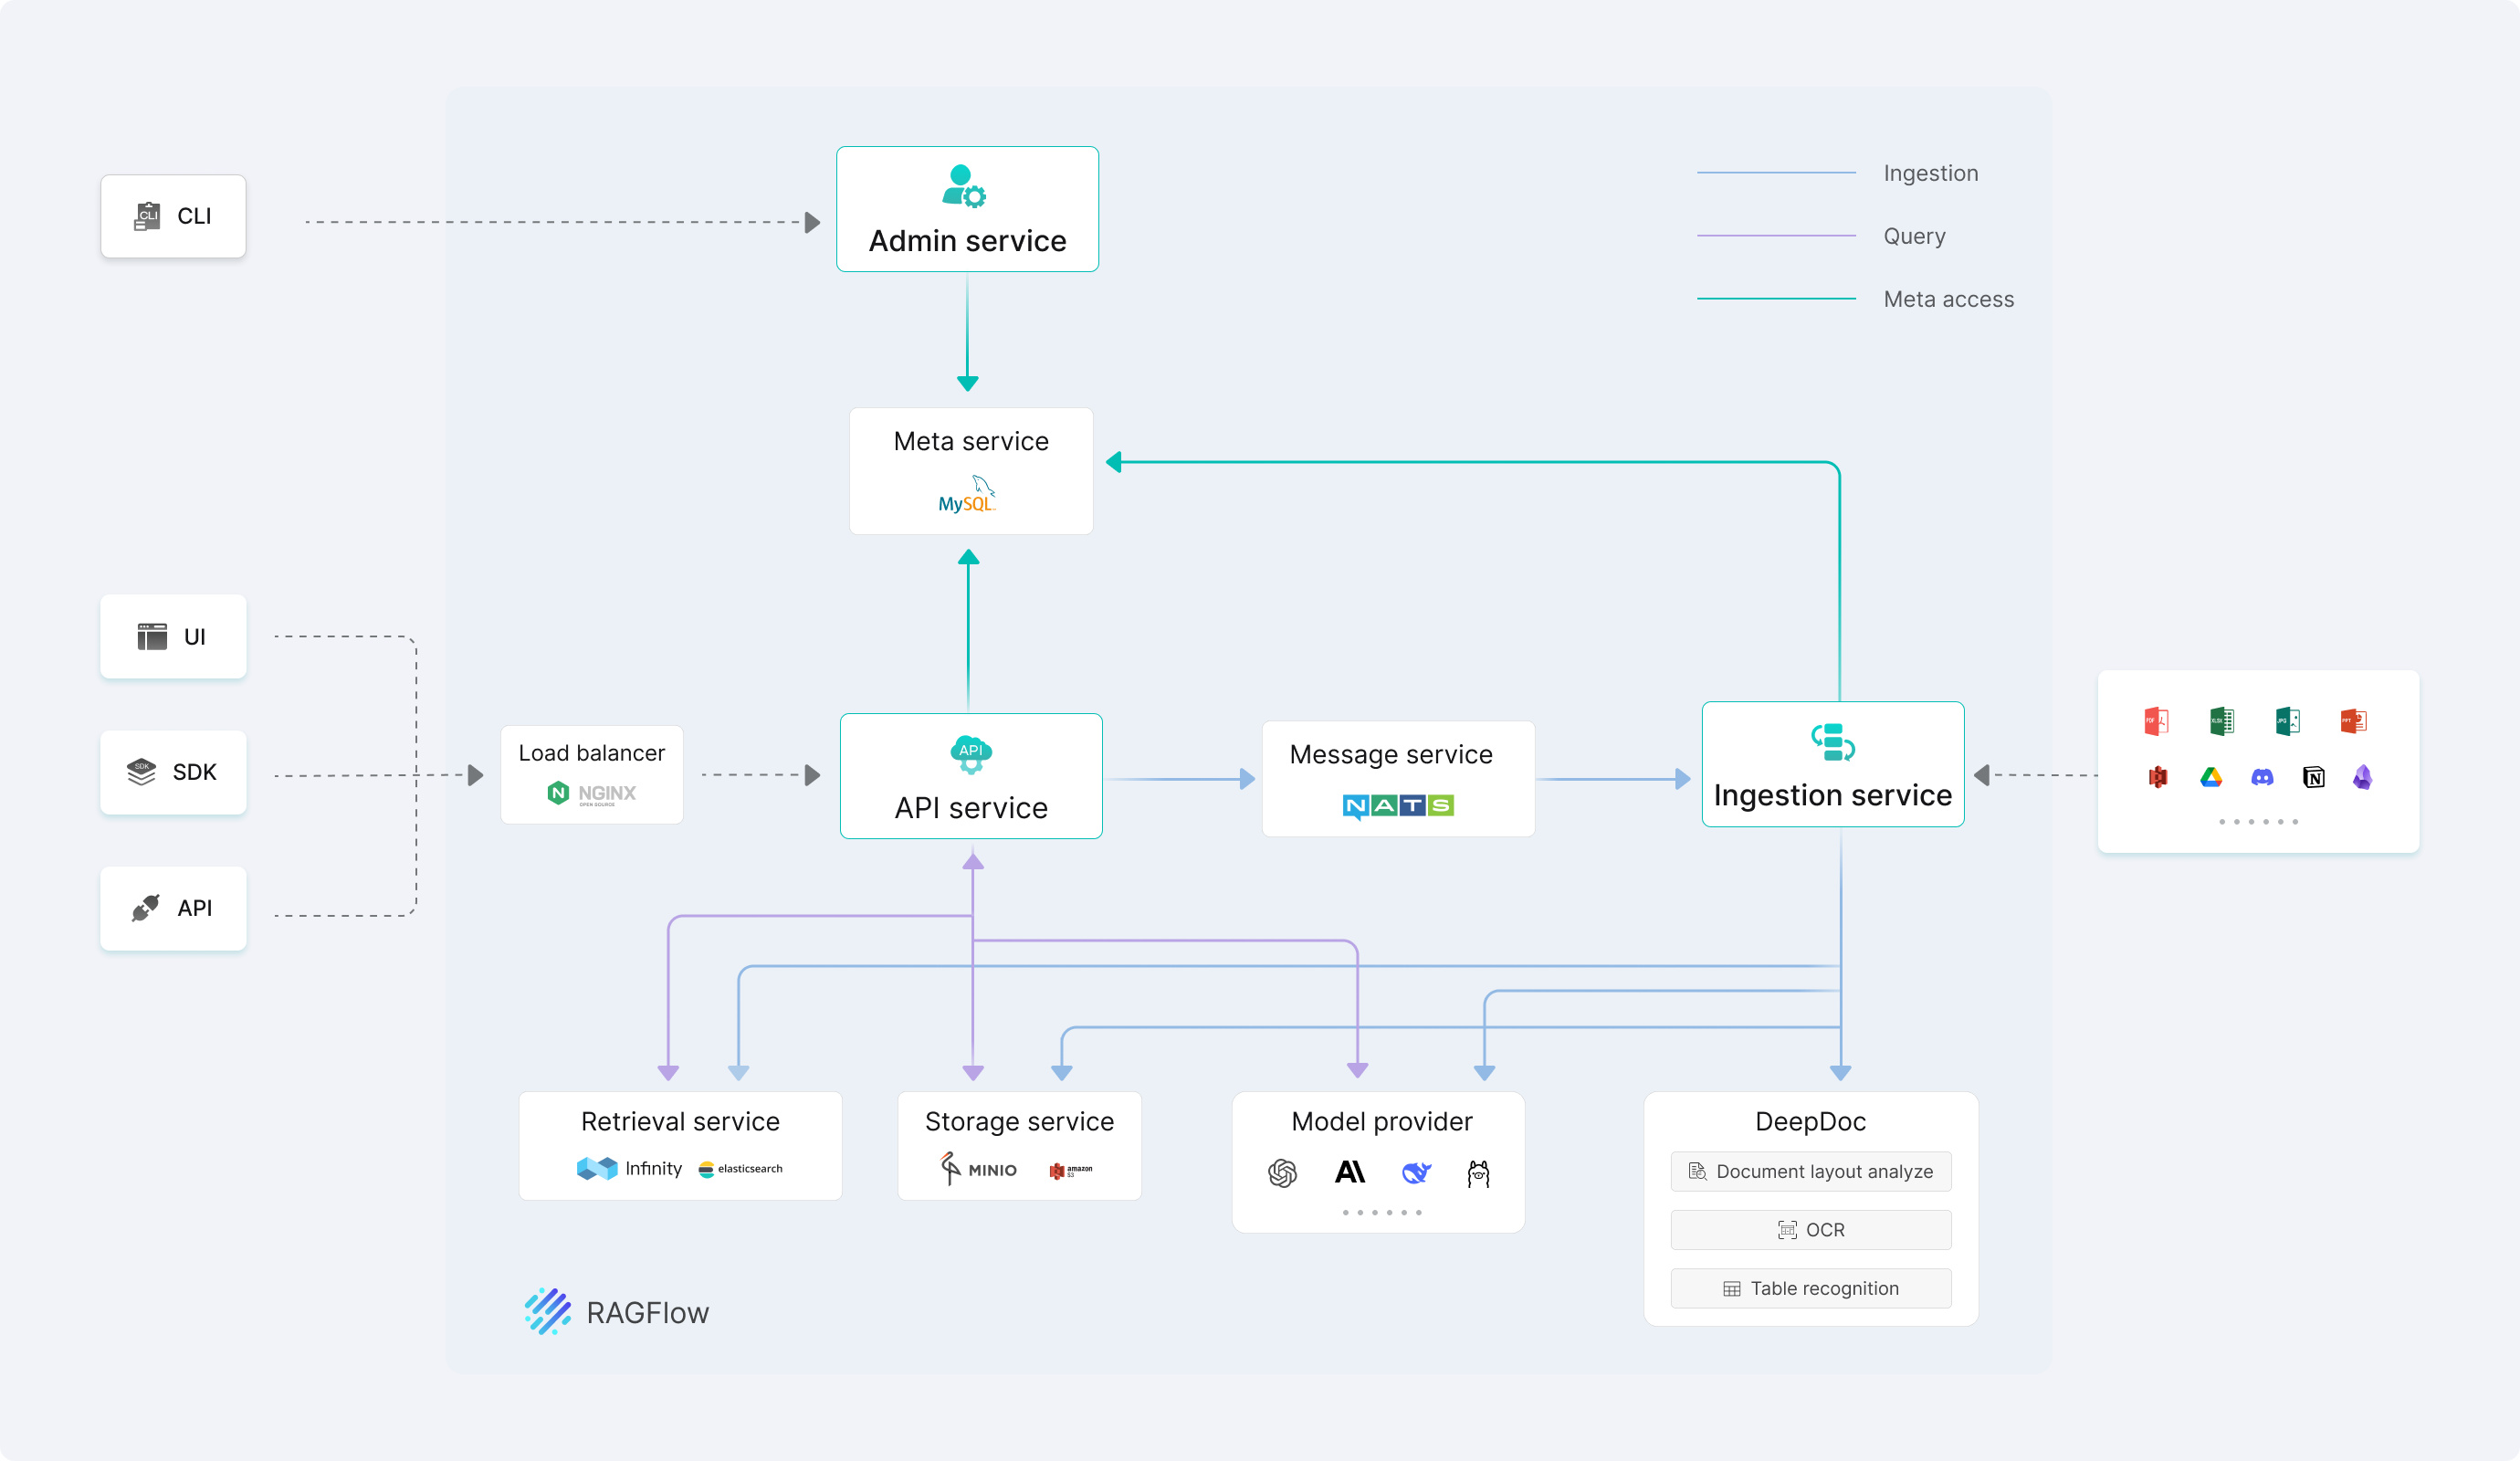
🔎 Architecture du système
🎬 Auto-hébergement
🐳 Déploiement Docker
📝 Prérequis du déploiement Docker
- Configuration de départ recommandée : 4 cœurs CPU, 16 Go de RAM et 50 Go d’espace disque disponible. Les besoins réels dépendent du moteur de documents, du volume de données, des tâches d’analyse et de la concurrence. Les modèles locaux et les autres composants facultatifs peuvent nécessiter des ressources supplémentaires.
- Docker >= 24.0.0 & Docker Compose >= v2.26.1
- gVisor : requis uniquement avec le Sandbox de conteneurs Self-Managed.
Le déploiement Docker ne nécessite pas l’installation de Go sur l’hôte. Le Sandbox de conteneurs Self-Managed nécessite l’installation et la configuration de gVisor ; les autres fournisseurs de Sandbox n’en ont pas besoin sur l’hôte RAGFlow.
Tip
Si vous n'avez pas installé Docker sur votre machine locale (Windows, Mac ou Linux), consultez Installer Docker Engine.
🚀 Démarrer le serveur
-
Assurez-vous que
vm.max_map_count>= 262144 :Pour vérifier la valeur de
vm.max_map_count:sysctl vm.max_map_countRéinitialisez
vm.max_map_countà une valeur d'au moins 262144 si ce n'est pas le cas.# Dans ce cas, nous le définissons à 262144 : sudo sysctl -w vm.max_map_count=262144Ce changement sera réinitialisé après un redémarrage du système. Pour que votre modification reste permanente, ajoutez ou mettez à jour la valeur
vm.max_map_countdans /etc/sysctl.conf :vm.max_map_count=262144 -
Clonez le dépôt :
git clone https://github.com/infiniflow/ragflow.git -
Passez à la balise de version Go et démarrez l’image Go préconstruite avec Docker Compose :
Accédez au répertoire de déploiement Docker.
cd ragflow/dockerBasculez vers la balise de version Go v1.0.0-rc1.
git checkout v1.0.0-rc1Démarrez les services Go et leurs dépendances en arrière-plan.
docker compose -f docker-compose.yml up -dAvec la configuration MySQL par défaut, le point d’entrée de l’image exécute d’abord les migrations, puis démarre Syncer, Admin, API et Ingestor via
bin/ragflow_server. Dans RAGFlow open-source 1.0, DeepDoc utilise l’inférence CPU pour l’analyse de mise en page, l’OCR et la reconnaissance des tableaux. -
Vérifiez l’état des services et la disponibilité de l’API après le démarrage :
docker psLa commande ci-dessus affiche l’état des dépendances. RAGFlow ne définit pas de healthcheck Compose ; confirmez sa disponibilité via son API :
curl -f http://localhost/api/v1/system/healthzUne réponse HTTP 200 indique que le service est prêt. Si
SVR_WEB_HTTP_PORTa été modifié, utilisez ce port dans l’URL de vérification. En cas d’échec du démarrage, consultez les journaux du service concerné avecdocker logs --tail 50 <service>. -
Dans votre navigateur web, entrez l'adresse IP de votre serveur et connectez-vous à RAGFlow.
Avec les paramètres par défaut, il vous suffit d'entrer
http://IP_OF_YOUR_MACHINE(sans numéro de port), car le port HTTP par défaut80peut être omis lors de l'utilisation des configurations par défaut. -
Après vous être connecté à RAGFlow, ajoutez le LLM, le modèle d'embedding et le reranker sur la page des fournisseurs de modèles, puis renseignez le nom du modèle, l'adresse du service et la clé API correspondants.
Voir llm_api_key_setup pour plus d'informations.
Le spectacle commence !
⚙️ Configuration et ajustement de Docker
Le déploiement Docker Go utilise docker/.env et docker/docker-compose.yml, Kvrocks pour le cache et le stockage des Checkpoints, et NATS JetStream comme file de messages. Pour configurer l’image, les ports, les mots de passe, le moteur de documents et la source des images de modèles, consultez le guide de configuration Docker. Pour la prise en charge des plateformes (note : macOS n'est temporairement pas pris en charge, utilisez un hôte Linux x86_64), consultez le guide de construction de l’image Go et de prise en charge des plateformes.
Pour changer de moteur de documents, modifier la configuration, redémarrer les services ou conserver/supprimer les données existantes, suivez également le guide de configuration Docker ci-dessus.
🔨 Lancer le service depuis les sources pour le développement
📝 Prérequis de la compilation depuis les sources
-
Installez la version de Go indiquée dans
go.mod(Go 1.27 actuellement), Clang 20, LLD 20, CMake 4.0 ou version ultérieure, ainsi que les fichiers de développement PCRE2. Les services Go dépendent de CGO et de bibliothèques natives ; build.sh configure les paramètres nécessaires. -
Clonez le dépôt, préparez les bibliothèques natives et les fichiers de modèles requis, puis compilez les services Go :
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/
python3 -m venv /tmp/ragflow-go-download-venv /tmp/ragflow-go-download-venv/bin/python -m pip install requests huggingface-hub /tmp/ragflow-go-download-venv/bin/python ragflow_deps/download_deps.py bash build.sh --allLe script prépare les bibliothèques natives et les ressources de modèles nécessaires à la compilation Go et requiert
requestsethuggingface-hub. Ignorez cette étape si vous avez préparé les mêmes ressources autrement. Depuis la racine du dépôt, les services Go trouvent automatiquementinternal/rag/res/deepdoc; depuis un autre répertoire, définissezDEEPDOC_MODEL_DIRsur son chemin absolu. -
Lancez les dépendances requises (Elasticsearch, MySQL, MinIO, NATS, Kvrocks et ClickHouse) avec Docker Compose :
sudo sysctl -w vm.max_map_count=262144
docker compose --env-file docker/.env -f docker/docker-compose-base.yml \
  up -d --wait es01 mysql minio nats kvrocks clickhouse
Les services Go lancés depuis les sources se connectent à Kvrocks via
localhost:6379, tandis que les services Docker utilisent le nom d'hôte du réseau de conteneurs. Aucune modification de/etc/hostsn'est nécessaire avec la configuration fournie. -
Exécutez d'abord la migration, puis démarrez Admin, Ingestor, Syncer et API dans quatre terminaux distincts depuis la racine du dépôt. Le terminal de migration peut être fermé une fois la commande terminée ; les quatre autres doivent rester ouverts :
Terminal 1 : migration
./bin/ragflow_server --migrateTerminal 2 : Admin, port cible 9381
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --adminTerminal 3 : Ingestor
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --ingestorTerminal 4 : Syncer
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --syncerTerminal 5 : API, port cible 9380
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --apiLes modes de démarrage fonctionnent comme suit :
--migrate: exécute les migrations de base de données puis quitte.--admin: démarre le service Admin pour les opérations de gestion et d'initialisation.--ingestor: démarre le service Ingestor pour l'ingestion et l'analyse des données.--syncer: démarre le service Syncer pour la synchronisation des données.--api: démarre le service API pour l'interface Web, les SDK et les clients externes.
RAGFLOW_DEV_MODE=trueest réservé au développement. Il désactive le contrôle de rétrogradation entre la version du code et celle des migrations, mais n'exécute aucune migration et ne modifie pas le schéma. Ne l'utilisez pas en production. Après la migration,RAGFLOW_DEV_MODE=true bash build.sh --runpeut démarrer Admin, Ingestor et API, mais pas Syncer. Pour démarrer la chaîne complète, exécutez séparémentRAGFLOW_DEV_MODE=true ./bin/ragflow_server --syncer. -
Installez Node.js et npm uniquement pour développer le front-end :
cd web
npm install
Lancez ensuite le service front-end :
API_PROXY_SCHEME=go npm run devDans un autre terminal, vérifiez ensuite que l'API Go est prête :
curl -f http://127.0.0.1:9380/api/v1/system/healthzUne réponse HTTP 200 indique que l'API répond. À la fin du développement, appuyez sur
Ctrl+Cdans chaque terminal de service. Pour arrêter les dépendances sans supprimer les conteneurs, exécutezdocker compose --env-file docker/.env -f docker/docker-compose-base.yml stop es01 mysql minio nats kvrocks clickhouse. Pour supprimer les conteneurs de dépendances et le réseau Compose tout en conservant les volumes nommés, exécutezdocker compose --env-file docker/.env -f docker/docker-compose-base.yml down.
Consultez Lancer le service depuis les sources pour plus de détails.
📚 Documentation
📜 Roadmap
Voir la Feuille de route RAGFlow 2026
🏄 Communauté
🙌 Contribuer
RAGFlow s'épanouit grâce à la collaboration open-source. Dans cet esprit, nous accueillons des contributions diverses de la communauté. Si vous souhaitez en faire partie, consultez d'abord nos Directives de contribution.