
18 KiB




Cloud | Documentação | Roadmap | Discord
📕 Índice
💡 O que é o RAGFlow?
RAGFlow é um mecanismo de RAG (Retrieval-Augmented Generation) open-source líder que fusiona tecnologias RAG de ponta com funcionalidades Agent para criar uma camada contextual superior para LLMs. Oferece um fluxo de trabalho RAG otimizado adaptável a empresas de qualquer escala. Alimentado por um motor de contexto convergente e modelos Agent pré-construídos, o RAGFlow permite que desenvolvedores transformem dados complexos em sistemas de IA de alta fidelidade e pronto para produção com excepcional eficiência e precisão.
🎮 Primeiros Passos
Experimente o nosso serviço na nuvem em https://cloud.ragflow.io.


🔥 Últimas Atualizações
-
2026-09-29 Lançamento do RAGFlow 1.0.0-rc1.
-
2026-09-10 Adicionada a ingestão de conteúdo da Web por meio de sitemaps.
-
2026-08-19 Lançado o Knowledge Compilation, que gera Wikis, Graphs, Trees, PageIndex, Mind Maps, Timelines e Skills nos níveis de documento e dataset.
-
2026-08-19 Lançado o Agentic RAG com os modos de pensamento Low, Medium, High e Ultra.
-
2026-07-02 Adicionadas a ingestão de dados do Google BigQuery e a sincronização incremental.
-
2026-06-29 Adicionados canais de chat para WhatsApp, DingTalk e WeCom.
-
2026-05-26 Adicionado o componente Browser, que permite aos Agents navegar e interagir com páginas da Web.
-
2026-04-21 Adicionados sete modelos integrados de pipeline de ingestão de dados.
-
2026-04-21 Adicionadas a publicação de aplicações Agent, a execução de código em sandbox e a geração de gráficos.
-
2026-04-21 Adicionados o armazenamento e a recuperação de memória em nível de usuário.
Consulte as notas de versão completas para ver outras atualizações.
🎉 Fique Ligado
⭐️ Dê uma estrela no nosso repositório para se manter atualizado com novas funcionalidades e melhorias empolgantes! Receba notificações instantâneas sobre novos lançamentos! 🌟
🌟 Principais Funcionalidades
🍭 "Qualidade entra, qualidade sai"
- Extração de conhecimento baseada em entendimento profundo de documentos a partir de dados não estruturados com formatos complicados.
- Encontra a "agulha no palheiro de dados" de literalmente tokens ilimitados.
🍱 Fragmentação baseada em templates
- Inteligente e explicável.
- Muitas opções de templates para escolher.
🧩 Compilação de conhecimento (Knowledge Compilation)
- Organize conteúdo de documentos e conjuntos de dados em artefatos estruturados, como Wiki, Graph, Tree, PageIndex, Mind Map, Timeline e Skills.
- Configure modelos de compilação e regras de processamento e visualize, atualize ou gere novamente os artefatos.
🧠 Recuperação agêntica (Agentic Retrieval)
- O modelo analisa perguntas complexas e, quando necessário, divide a questão, pesquisa conhecimentos e verifica evidências em várias etapas.
- Os modos Low, Medium, High e Ultra permitem ajustar a profundidade da busca e do raciocínio à complexidade da pergunta.
🌱 Citações fundamentadas com menos alucinações
- Visualização da fragmentação de texto para permitir intervenção humana.
- Visualização rápida das referências chave e citações rastreáveis para apoiar respostas fundamentadas.
🍔 Compatibilidade com fontes de dados heterogêneas
- Suporta Word, apresentações, excel, txt, imagens, cópias digitalizadas, dados estruturados, páginas da web e mais.
🛀 Fluxo de trabalho RAG automatizado e sem esforço
- Orquestração RAG simplificada voltada tanto para negócios pessoais quanto grandes empresas.
- Modelos LLM e de incorporação configuráveis.
- Múltiplas recuperações emparelhadas com reclassificação fundida.
- APIs intuitivas para integração sem problemas com os negócios.
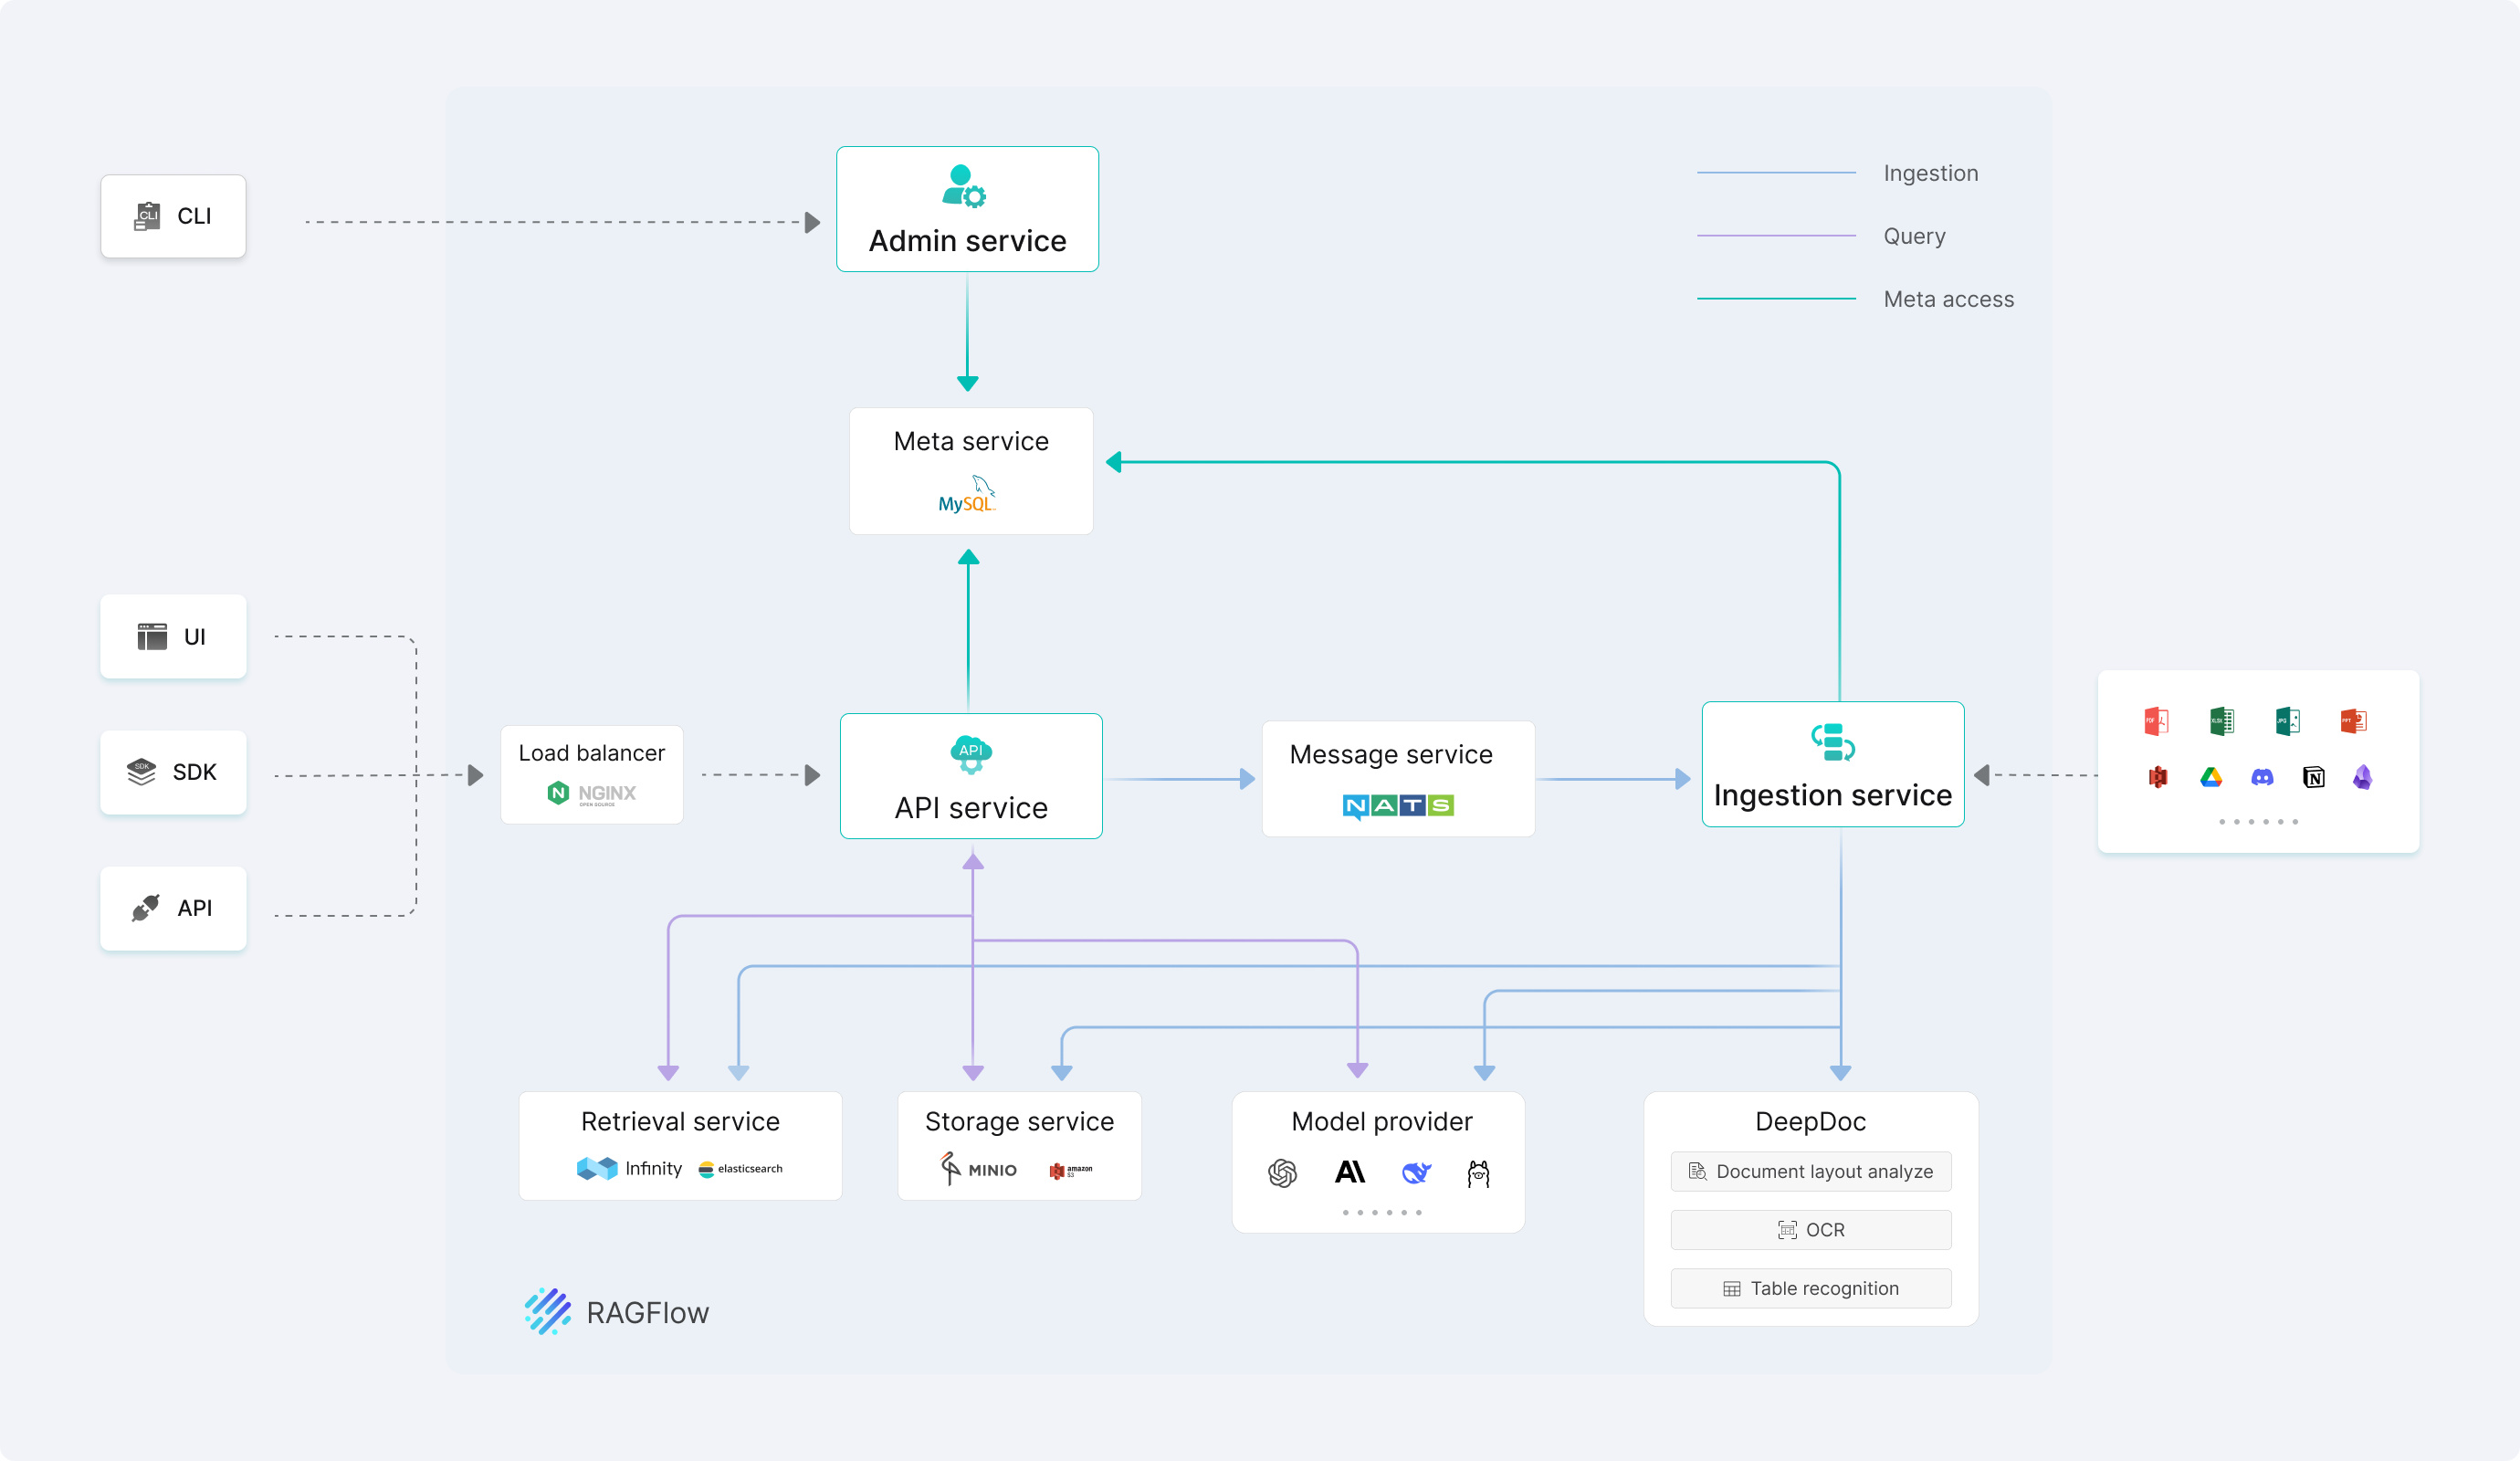
🔎 Arquitetura do Sistema
🎬 Auto-hospedagem
🐳 Implantação com Docker
📝 Pré-requisitos da implantação com Docker
- Configuração inicial recomendada: 4 núcleos de CPU, 16 GB de RAM e 50 GB de espaço em disco disponível. Os requisitos reais dependem do mecanismo de documentos, volume de dados, tarefas de análise e concorrência. Modelos locais e outros componentes opcionais podem exigir recursos adicionais.
- Docker >= 24.0.0 & Docker Compose >= v2.26.1
- gVisor: Necessário somente ao usar o Sandbox de contêineres Self-Managed.
A implantação Docker não exige a instalação do Go no host. O Sandbox de contêineres Self-Managed exige instalação e configuração do gVisor; outros provedores de Sandbox não exigem gVisor no host do RAGFlow.
Tip
Se você não instalou o Docker na sua máquina local (Windows, Mac ou Linux), veja Instalar Docker Engine.
🚀 Iniciar o servidor
-
Certifique-se de que
vm.max_map_count>= 262144:Para verificar o valor de
vm.max_map_count:sysctl vm.max_map_countSe necessário, redefina
vm.max_map_countpara um valor de pelo menos 262144:# Neste caso, defina para 262144: sudo sysctl -w vm.max_map_count=262144Essa mudança será resetada após a reinicialização do sistema. Para garantir que a alteração permaneça permanente, adicione ou atualize o valor de
vm.max_map_countem /etc/sysctl.conf:vm.max_map_count=262144 -
Clone o repositório:
git clone https://github.com/infiniflow/ragflow.git -
Mude para a tag de lançamento Go e inicie a imagem Go pré-criada com o Docker Compose:
Entre no diretório de implantação do Docker.
cd ragflow/dockerMude para a tag de lançamento Go v1.0.0-rc1.
git checkout v1.0.0-rc1Inicie os serviços Go e suas dependências em segundo plano.
docker compose -f docker-compose.yml up -dNa configuração padrão do MySQL, o entrypoint da imagem executa as migrações do banco de dados e inicia Syncer, Admin, API e Ingestor por meio de
bin/ragflow_server. No RAGFlow open-source 1.0, DeepDoc usa inferência por CPU para análise de layout, OCR e reconhecimento de tabelas. -
Verifique o estado dos serviços e a prontidão da API após a inicialização:
docker psO comando acima exibe o estado das dependências. O RAGFlow não define um healthcheck do Compose; confirme a prontidão pela API:
curl -f http://localhost/api/v1/system/healthzUma resposta HTTP 200 indica que o serviço está pronto. Se
SVR_WEB_HTTP_PORTfoi alterado, use essa porta na URL de verificação. Se a inicialização falhar, consulte os logs do serviço correspondente comdocker logs --tail 50 <service>. -
No seu navegador, insira o endereço IP do seu servidor e faça login no RAGFlow.
Com as configurações padrão, você só precisa digitar
http://IP_DO_SEU_MÁQUINA(sem o número da porta), pois a porta HTTP padrão80pode ser omitida ao usar as configurações padrão. -
Após entrar, adicione um LLM, um modelo de embedding e um reranker na página de provedores de modelos, incluindo o nome do modelo, o endereço do serviço e a chave de API.
O show está no ar!
⚙️ Configuração e ajustes do Docker
A implantação Go com Docker usa docker/.env e docker/docker-compose.yml, com Kvrocks para cache e armazenamento de Checkpoints e NATS JetStream como fila de mensagens. Para configurar imagem, portas, senhas, mecanismo de documentos e origem das imagens de modelos, consulte o guia de configuração do Docker. Para suporte de plataforma (observação: macOS não é suportado temporariamente, use um host Linux x86_64), consulte o guia de build da imagem Go e suporte a plataformas.
Para trocar o mecanismo de documentos, alterar configurações, reiniciar serviços e manter ou remover dados existentes, siga também o guia de configuração do Docker.
🔨 Lançar o serviço a partir do código-fonte para desenvolvimento
📝 Pré-requisitos da compilação a partir do código-fonte
-
Instale a versão do Go especificada em
go.mod(atualmente Go 1.27), Clang 20, LLD 20, CMake 4.0 ou superior e os arquivos de desenvolvimento do PCRE2. Os serviços Go dependem de CGO e bibliotecas nativas; o build.sh configura os parâmetros necessários. -
Clone o repositório, prepare as bibliotecas nativas e os arquivos de modelo necessários e compile os serviços Go:
git clone https://github.com/infiniflow/ragflow.git
cd ragflow/
python3 -m venv /tmp/ragflow-go-download-venv /tmp/ragflow-go-download-venv/bin/python -m pip install requests huggingface-hub /tmp/ragflow-go-download-venv/bin/python ragflow_deps/download_deps.py bash build.sh --allO script prepara as bibliotecas nativas e os recursos de modelo necessários para o build Go e requer
requestsehuggingface-hub. Ignore esta etapa se você já preparou os mesmos recursos de outra forma. Quando iniciados na raiz do repositório, os serviços Go encontram automaticamenteinternal/rag/res/deepdoc; para iniciar em outro diretório, definaDEEPDOC_MODEL_DIRcomo o caminho absoluto correspondente. -
Inicie as dependências necessárias (Elasticsearch, MySQL, MinIO, NATS, Kvrocks e ClickHouse) usando Docker Compose:
sudo sysctl -w vm.max_map_count=262144
docker compose --env-file docker/.env -f docker/docker-compose-base.yml \
  up -d --wait es01 mysql minio nats kvrocks clickhouse
Os serviços Go iniciados pelo código-fonte acessam o Kvrocks exposto pelo Compose em
localhost:6379; os serviços Docker usam o nome do host na rede dos contêineres. A configuração fornecida não exige alterações em/etc/hosts. -
Execute primeiro a migração e depois inicie Admin, Ingestor, Syncer e API em quatro terminais separados, sempre na raiz do repositório. O terminal da migração pode ser fechado quando o comando terminar; os outros quatro devem permanecer abertos:
Terminal 1: migração
./bin/ragflow_server --migrateTerminal 2: Admin, porta de destino 9381
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --adminTerminal 3: Ingestor
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --ingestorTerminal 4: Syncer
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --syncerTerminal 5: API, porta de destino 9380
RAGFLOW_DEV_MODE=true ./bin/ragflow_server --apiOs modos de inicialização funcionam assim:
--migrate: Executa as migrações do banco de dados e encerra.--admin: Inicia o serviço Admin para operações de gerenciamento e inicialização.--ingestor: Inicia o serviço Ingestor para tarefas de ingestão e análise de dados.--syncer: Inicia o serviço Syncer para tarefas de sincronização de dados.--api: Inicia o serviço API para a interface Web, SDKs e clientes externos.
RAGFLOW_DEV_MODE=trueé exclusivo para desenvolvimento. Ele desativa a verificação de downgrade entre o código e as migrações, mas não executa migrações nem altera o esquema. Não o use em produção. Depois da migração,RAGFLOW_DEV_MODE=true bash build.sh --runpode iniciar Admin, Ingestor e API, mas não inicia o Syncer. Para iniciar a cadeia completa de serviços, execute separadamenteRAGFLOW_DEV_MODE=true ./bin/ragflow_server --syncer. -
Instale Node.js e npm somente se for desenvolver o front-end:
cd web
npm install
Em seguida, inicie o serviço de front-end:
API_PROXY_SCHEME=go npm run devEm outro terminal, confirme que a API Go está pronta:
curl -f http://127.0.0.1:9380/api/v1/system/healthzUma resposta HTTP 200 indica que a API está respondendo. Ao concluir o desenvolvimento, pressione
Ctrl+Cem cada terminal de serviço. Para interromper as dependências mantendo os contêineres, executedocker compose --env-file docker/.env -f docker/docker-compose-base.yml stop es01 mysql minio nats kvrocks clickhouse. Para remover os contêineres de dependência e a rede Compose mantendo os volumes nomeados, executedocker compose --env-file docker/.env -f docker/docker-compose-base.yml down.
Consulte Iniciar o serviço a partir do código-fonte para obter detalhes.
📚 Documentação
📜 Roadmap
Veja o RAGFlow Roadmap 2026
🏄 Comunidade
🙌 Contribuindo
O RAGFlow prospera por meio da colaboração de código aberto. Com esse espírito, abraçamos contribuições diversas da comunidade. Se você deseja fazer parte, primeiro revise nossas Diretrizes de Contribuição.