mirror of
https://github.com/linkedin/Liger-Kernel.git
synced 2026-10-12 02:17:47 +00:00
Merge branch 'main' into tcc/bench_vis
This commit is contained in:
 Shao Tang
@@ -65,6 +65,8 @@ We've also added optimized Post-Training kernels that deliver **up to 80% memory
|
||||
|
||||
You can view the documentation site for additional installation, usage examples, and API references:https://linkedin.github.io/Liger-Kernel/
|
||||
|
||||
You can view the Liger Kernel Technical Report: https://openreview.net/forum?id=36SjAIT42G
|
||||
|
||||
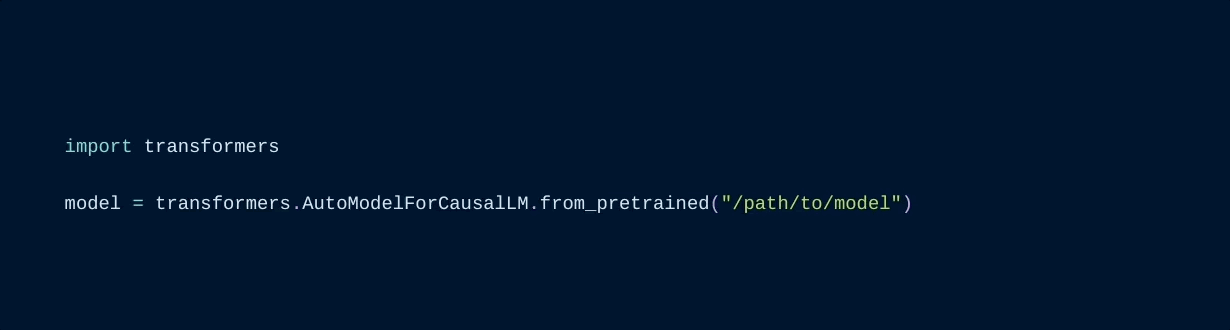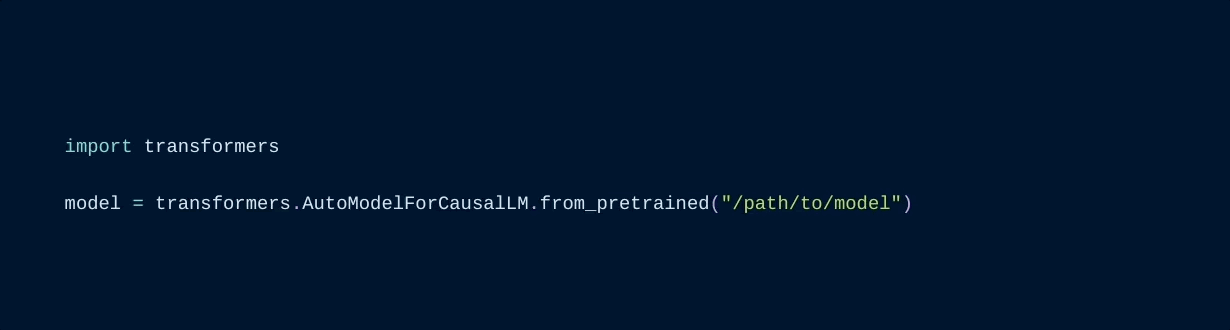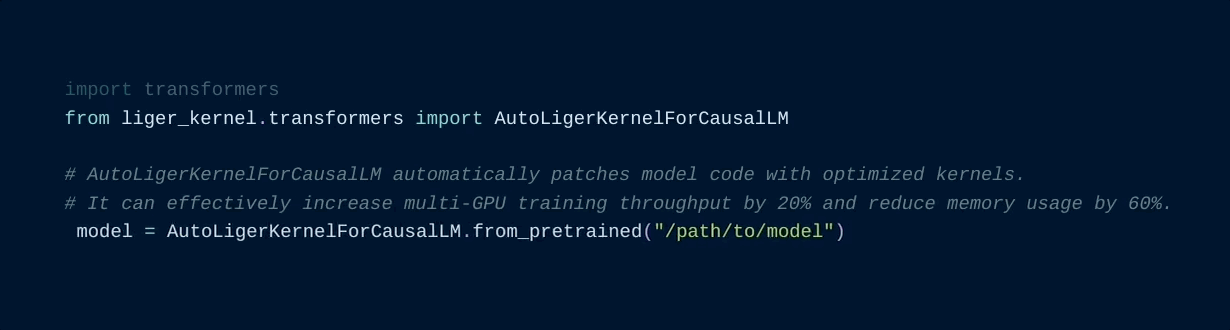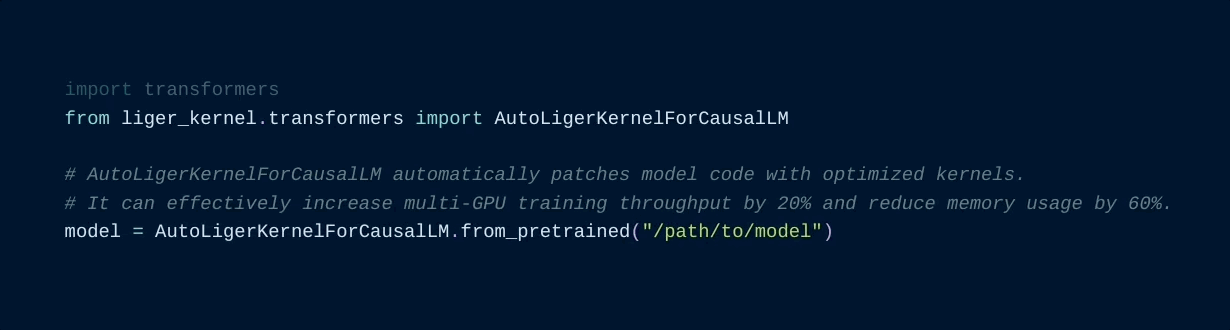
## Supercharge Your Model with Liger Kernel
|
||||
|
||||
|
||||
@@ -394,3 +396,4 @@ url={https://openreview.net/forum?id=36SjAIT42G}
|
||||
↑ Back to Top ↑
|
||||
</a>
|
||||
</p>
|
||||
|
||||
|
||||
@@ -35,8 +35,7 @@ from liger_kernel.transformers.model.smollm3 import lce_forward as smollm3_lce_f
|
||||
from liger_kernel.transformers.qwen2vl_mrope import liger_multimodal_rotary_pos_emb
|
||||
from liger_kernel.transformers.rms_norm import LigerRMSNorm
|
||||
from liger_kernel.transformers.rope import liger_rotary_pos_emb
|
||||
from liger_kernel.transformers.rope import liger_rotary_pos_emb_with_cast
|
||||
from liger_kernel.transformers.rope import liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
from liger_kernel.transformers.rope import liger_rotary_pos_emb_vision
|
||||
from liger_kernel.transformers.swiglu import LigerBlockSparseTop2MLP
|
||||
from liger_kernel.transformers.swiglu import LigerPhi3SwiGLUMLP
|
||||
from liger_kernel.transformers.swiglu import LigerSwiGLUMLP
|
||||
@@ -1754,8 +1753,8 @@ def apply_liger_kernel_to_qwen3_vl(
|
||||
from liger_kernel.transformers.model.qwen3_vl import lce_forward as qwen3_vl_lce_forward
|
||||
|
||||
if rope:
|
||||
modeling_qwen3_vl.apply_rotary_pos_emb = liger_rotary_pos_emb_with_cast
|
||||
modeling_qwen3_vl.apply_rotary_pos_emb_vision = liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
modeling_qwen3_vl.apply_rotary_pos_emb = liger_rotary_pos_emb
|
||||
modeling_qwen3_vl.apply_rotary_pos_emb_vision = liger_rotary_pos_emb_vision
|
||||
|
||||
if rms_norm:
|
||||
modeling_qwen3_vl.Qwen3VLTextRMSNorm = LigerRMSNorm
|
||||
@@ -1829,8 +1828,8 @@ def apply_liger_kernel_to_qwen3_vl_moe(
|
||||
from liger_kernel.transformers.model.qwen3_vl_moe import lce_forward as qwen3_vl_moe_lce_forward
|
||||
|
||||
if rope:
|
||||
modeling_qwen3_vl_moe.apply_rotary_pos_emb = liger_rotary_pos_emb_with_cast
|
||||
modeling_qwen3_vl_moe.apply_rotary_pos_emb_vision = liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
modeling_qwen3_vl_moe.apply_rotary_pos_emb = liger_rotary_pos_emb
|
||||
modeling_qwen3_vl_moe.apply_rotary_pos_emb_vision = liger_rotary_pos_emb_vision
|
||||
|
||||
if rms_norm:
|
||||
modeling_qwen3_vl_moe.Qwen3VLMoeTextRMSNorm = LigerRMSNorm
|
||||
|
||||
@@ -1,4 +1,3 @@
|
||||
from typing import Optional
|
||||
from typing import Tuple
|
||||
|
||||
import torch
|
||||
@@ -25,39 +24,41 @@ def liger_rotary_pos_emb(q, k, cos, sin, position_ids=None, unsqueeze_dim=1):
|
||||
return LigerRopeFunction.apply(q, k, cos, sin, position_ids, unsqueeze_dim)
|
||||
|
||||
|
||||
def liger_rotary_pos_emb_with_cast(
|
||||
def liger_rotary_pos_emb_vision(
|
||||
q: torch.Tensor,
|
||||
k: torch.Tensor,
|
||||
cos: torch.Tensor,
|
||||
sin: torch.Tensor,
|
||||
position_ids: Optional[torch.Tensor] = None,
|
||||
unsqueeze_dim: int = 1,
|
||||
) -> Tuple[torch.Tensor, torch.Tensor]:
|
||||
"""
|
||||
Modified version of liger_rotary_pos_emb for qwen3_vl's apply_rotary_pos_emb_vision function.
|
||||
Manually tranposed the input and output to match the expected shape for liger_rotary_pos_emb.
|
||||
Reference: https://https://github.com/huggingface/transformers/blob/v5.0.0rc0/src/transformers/models/qwen3_vl/modeling_qwen3_vl.py#L116
|
||||
|
||||
Args:
|
||||
q (torch.Tensor): The query tensor of shape (seq_length, num_heads, head_dim),
|
||||
with stride (num_heads * head_dim, head_dim, 1).
|
||||
k (torch.Tensor): The query tensor of shape (seq_length, num_heads, head_dim),
|
||||
with stride (num_heads * head_dim, head_dim, 1). Same as q.
|
||||
cos (torch.Tensor): The cosine tensor of shape (seq_length, head_dim).
|
||||
sin (torch.Tensor): The sine tensor of shape (seq_length, head_dim).
|
||||
|
||||
Returns:
|
||||
Tuple[torch.Tensor, torch.Tensor]: The query and key tensors with the same shape and stride as inputs.
|
||||
"""
|
||||
orig_q_dtype, orig_k_dtype = q.dtype, k.dtype
|
||||
|
||||
q32 = q.to(torch.float32)
|
||||
k32 = k.to(torch.float32)
|
||||
# tranpose to (1, num_heads, seq_length, head_dim) and cast to float32 to match liger_rotary_pos_emb input shape
|
||||
# also unsqueeze for batch dim
|
||||
q32 = q.to(torch.float32).unsqueeze(0).transpose(1, 2)
|
||||
k32 = k.to(torch.float32).unsqueeze(0).transpose(1, 2)
|
||||
cos32 = cos.to(torch.float32)
|
||||
sin32 = sin.to(torch.float32)
|
||||
|
||||
q_out, k_out = liger_rotary_pos_emb(q32, k32, cos32, sin32, position_ids=position_ids, unsqueeze_dim=unsqueeze_dim)
|
||||
return q_out.to(orig_q_dtype), k_out.to(orig_k_dtype)
|
||||
q_out, k_out = liger_rotary_pos_emb(q32, k32, cos32, sin32)
|
||||
|
||||
|
||||
def liger_rotary_pos_emb_with_cast_and_leading_batch(
|
||||
q: torch.Tensor,
|
||||
k: torch.Tensor,
|
||||
cos: torch.Tensor,
|
||||
sin: torch.Tensor,
|
||||
position_ids: Optional[torch.Tensor] = None,
|
||||
unsqueeze_dim: int = 1,
|
||||
) -> Tuple[torch.Tensor, torch.Tensor]:
|
||||
orig_q_dtype, orig_k_dtype = q.dtype, k.dtype
|
||||
|
||||
q32 = q.to(torch.float32).unsqueeze(0)
|
||||
k32 = k.to(torch.float32).unsqueeze(0)
|
||||
cos32 = cos.to(torch.float32).unsqueeze(0)
|
||||
sin32 = sin.to(torch.float32).unsqueeze(0)
|
||||
|
||||
q_out, k_out = liger_rotary_pos_emb(q32, k32, cos32, sin32, position_ids=position_ids, unsqueeze_dim=unsqueeze_dim)
|
||||
return q_out.to(orig_q_dtype).squeeze(0), k_out.to(orig_k_dtype).squeeze(0)
|
||||
# transpose back to (seq_length, num_heads, head_dim) and cast back to original dtype
|
||||
# also squeeze out batch dim
|
||||
q_out = q_out.transpose(1, 2).squeeze(0).to(orig_q_dtype)
|
||||
k_out = k_out.transpose(1, 2).squeeze(0).to(orig_k_dtype)
|
||||
return q_out, k_out
|
||||
|
||||
@@ -1019,8 +1019,8 @@ def test_apply_liger_kernel_to_instance_for_qwen3_vl_moe_text():
|
||||
def test_qwen3_vl_rope_hooks_applied():
|
||||
# Ensure any monkey patching is cleaned up for subsequent tests
|
||||
with patch("transformers.models.qwen3_vl.modeling_qwen3_vl") as modeling_mod:
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb_with_cast
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb_vision
|
||||
|
||||
# Before applying, make sure attributes exist but are not the liger implementations
|
||||
setattr(modeling_mod, "apply_rotary_pos_emb", object())
|
||||
@@ -1028,16 +1028,16 @@ def test_qwen3_vl_rope_hooks_applied():
|
||||
|
||||
_apply_liger_kernel("qwen3_vl")
|
||||
|
||||
assert modeling_mod.apply_rotary_pos_emb is liger_rotary_pos_emb_with_cast
|
||||
assert modeling_mod.apply_rotary_pos_emb_vision is liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
assert modeling_mod.apply_rotary_pos_emb is liger_rotary_pos_emb
|
||||
assert modeling_mod.apply_rotary_pos_emb_vision is liger_rotary_pos_emb_vision
|
||||
|
||||
|
||||
@pytest.mark.skipif(not is_qwen3_vl_moe_available(), reason="qwen3_vl_moe module not available")
|
||||
def test_qwen3_vl_moe_rope_hooks_applied():
|
||||
# Ensure any monkey patching is cleaned up for subsequent tests
|
||||
with patch("transformers.models.qwen3_vl_moe.modeling_qwen3_vl_moe") as modeling_mod:
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb_with_cast
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb
|
||||
from liger_kernel.transformers.monkey_patch import liger_rotary_pos_emb_vision
|
||||
|
||||
# Before applying, make sure attributes exist but are not the liger implementations
|
||||
setattr(modeling_mod, "apply_rotary_pos_emb", object())
|
||||
@@ -1045,8 +1045,8 @@ def test_qwen3_vl_moe_rope_hooks_applied():
|
||||
|
||||
_apply_liger_kernel("qwen3_vl_moe")
|
||||
|
||||
assert modeling_mod.apply_rotary_pos_emb is liger_rotary_pos_emb_with_cast
|
||||
assert modeling_mod.apply_rotary_pos_emb_vision is liger_rotary_pos_emb_with_cast_and_leading_batch
|
||||
assert modeling_mod.apply_rotary_pos_emb is liger_rotary_pos_emb
|
||||
assert modeling_mod.apply_rotary_pos_emb_vision is liger_rotary_pos_emb_vision
|
||||
|
||||
|
||||
@pytest.mark.skipif(not is_falcon_h1_available(), reason="falcon_h1 module not available")
|
||||
|
||||
Reference in New Issue
Block a user